英語インタビューの文字起こしをAIでテストしてみた ― 2026年2月26日の結果(Whisper BASE、約11分の音声)
2026-02-26Test

Eric King
Author
1. なぜこのインタビュー・ベンチマークが重要なのか
現実のインタビューにおいて、文字起こしの精度は「あれば便利」ではなく必須条件です。ゲストの発言を安全に引用できるか、重要なトピックを検索できるか、その後の分析が発言内容を歪めずに行えるかは、すべて文字起こしの品質に依存します。ひとつの形容詞の抜け、数値の聞き間違い、固有名詞の誤認だけで、回答の意味は大きく変わり得ます。
本ベンチマークでは、「Bill インタビュー」の英語クリップを Whisper ベースの文字起こしパイプラインに通し、標準的な ASR 指標で評価しました。狙いはプロモーションではなく、実際の中程度の長さのインタビューに対して、システムがどのように振る舞うかを示す具体的で再現可能なスナップショットを提示することです。
元のインタビュー音声は YouTube 動画に対応しており、コンテキストの参考として視聴できます:
YouTube 上の元インタビュー動画。
YouTube 上の元インタビュー動画。
Source Materials
本ベンチマークで使用した入力データはすべてリポジトリまたは静的リソースとして公開されており、直接確認できます:
- 元音声: Audio source
- 人手による参照文字起こし(VTT): Base text
- モデル出力の文字起こし(VTT): Result text
この記事で用いる数値および結論は、すべてこれらのファイルに基づいています。
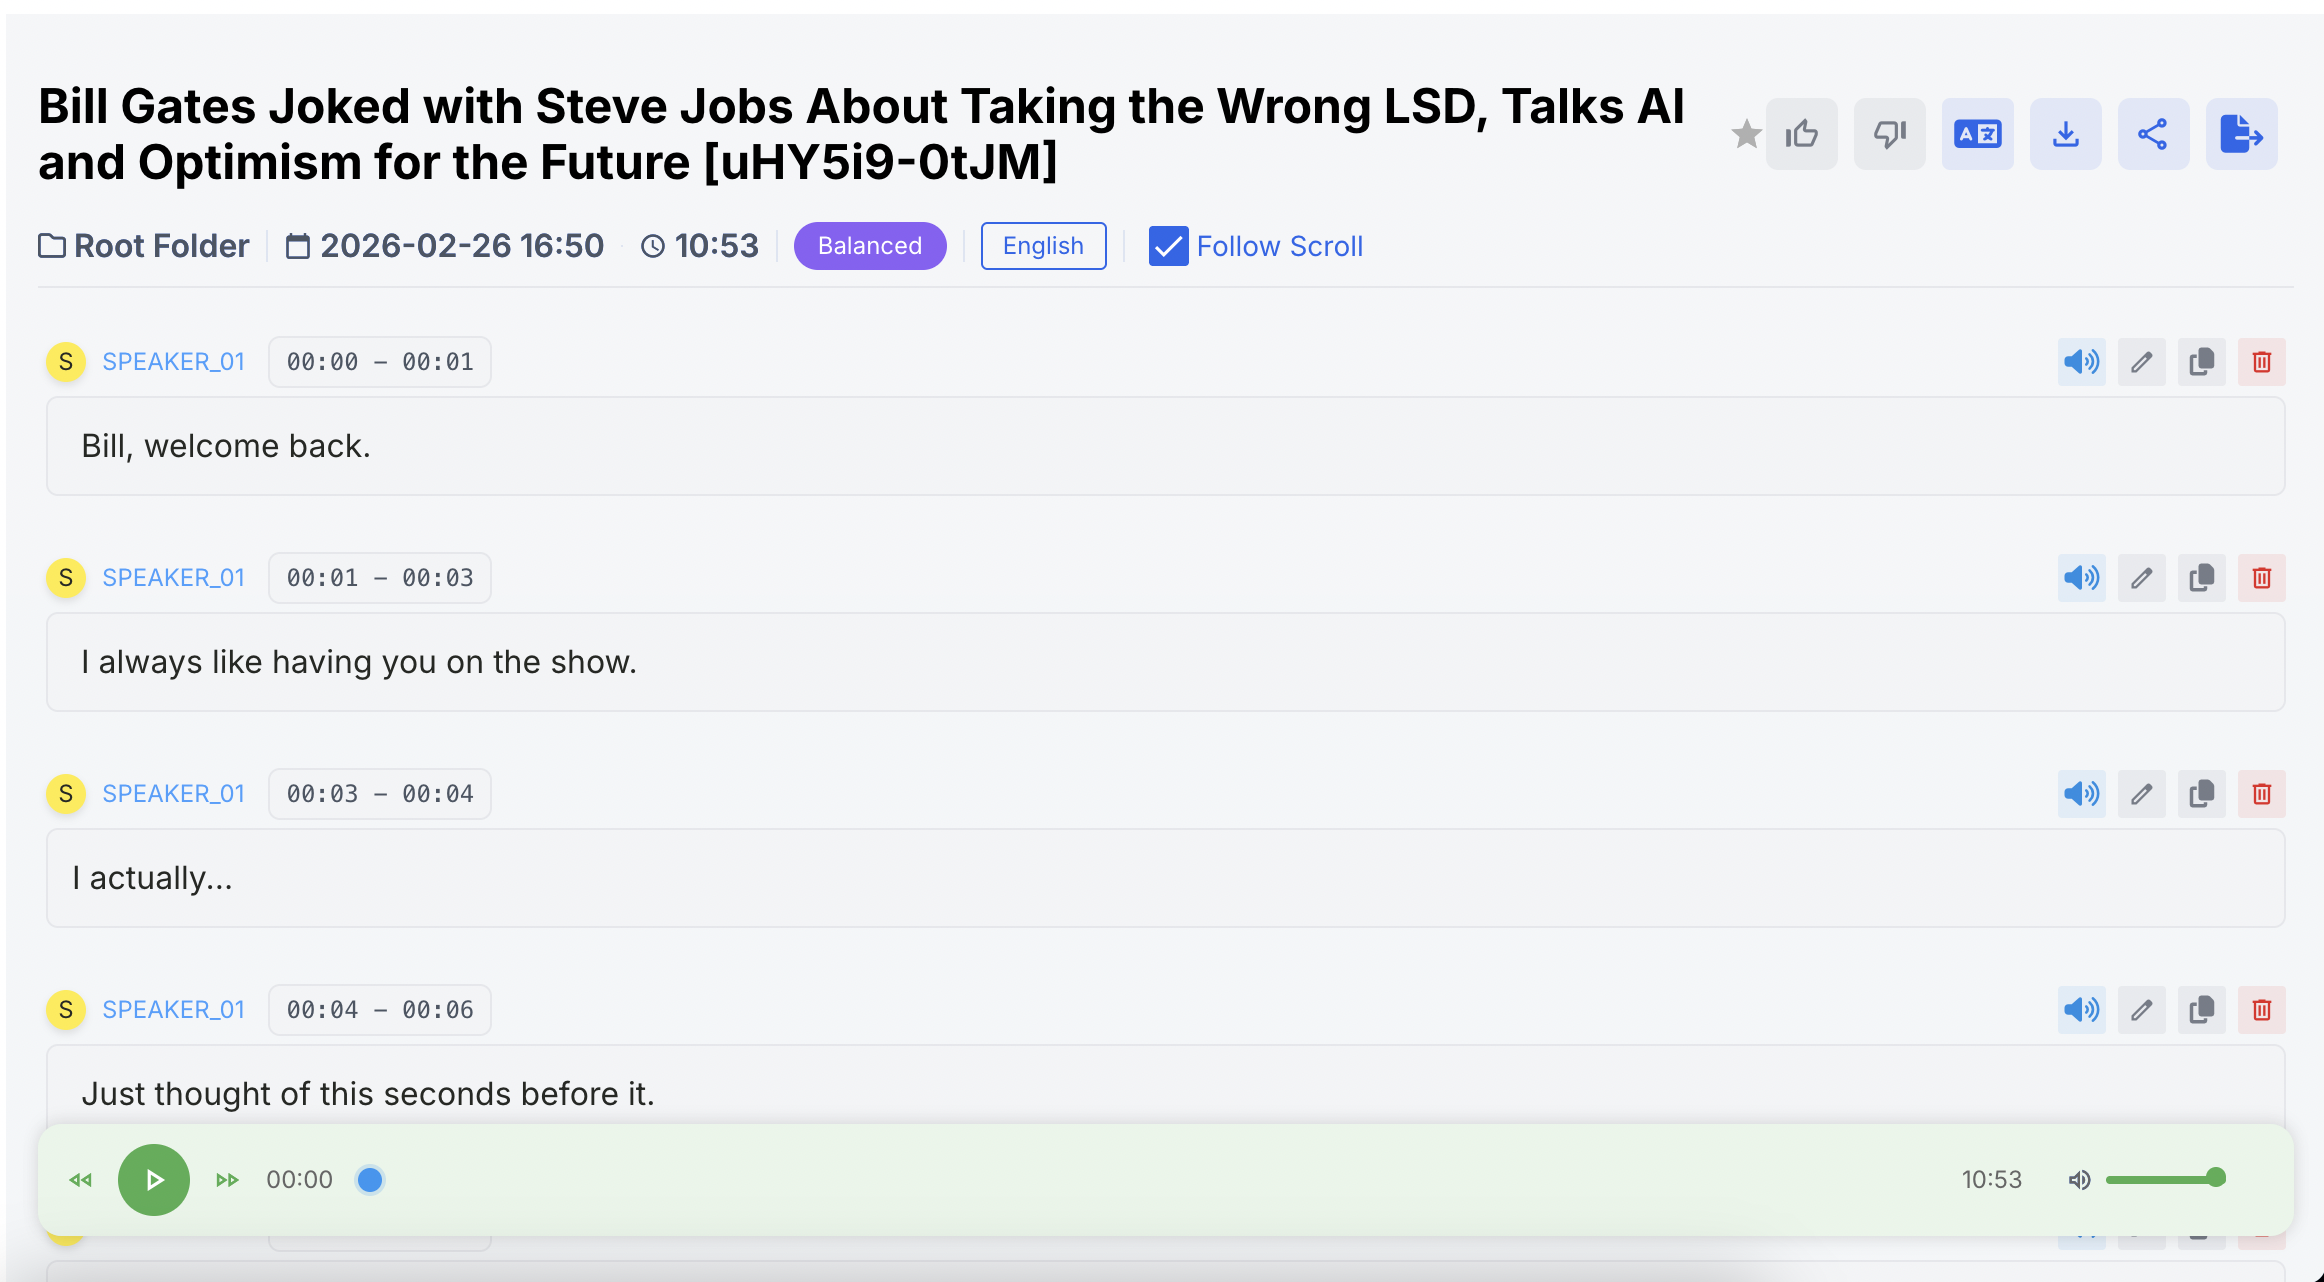
Screenshots from this run
2. テスト設定 (Testing Setup)
今回の実験では、以下の設定を用いました(すべての値は事前に計算されたメタデータおよび
result.json から取得しています):- 実行日: 2026‑02‑26(処理タイムスタンプから算出)
- シナリオ: 英語インタビュー(
test-transcripts/bill-interview) - 言語: 英語
- 音声の長さ:
audioDurationSeconds = 653.2934375- 約 10.89 分 の音声
- 処理時間:
sttProcessingTimeSeconds = 85.476- 約 1.42 分 のエンドツーエンド推論時間
- モデル / モード:
whisper-model: BASEsaytowords-mode: base
録音環境、マイクの種類、話速や話者密度などはメタデータに明示されていないため、ここでは仮定や憶測は行いません。アラインメントとスコアリング処理は本レポートの作成前に完了しており、以降の数値は
test-transcripts/bill-interview/result.json から直接読み取ったものです。3. 評価手法 (Evaluation Methodology)
人手の参照文字起こし(
ref.vtt)とモデル出力(model.vtt)はいずれも WebVTT 形式で保存されています。評価パイプラインは、まずこれらのファイルからプレーンテキストを抽出し、参照と仮説をアラインメントしたうえで、各種誤り指標を計算します。Word Error Rate (WER)
テキストを単語列にトークナイズした後、以下を数えます:
- (S): 置換(substitutions)
- (D): 削除(deletions)
- (I): 挿入(insertions)
- (N): 参照文字起こしにおける総単語数
Word Error Rate は次のように定義されます:
[
\text{WER} = \frac{S + D + I}{N}
]
これに基づき、単語レベルの**Accuracy(精度)**は:
[
\text{Accuracy} = 1 - \text{WER}
]
Character Error Rate (CER)
文字レベルでは空白文字を取り除いた上で、Levenshtein 型の編集距離を計算します:
- 文字編集距離:挿入・削除・置換の総数
- 総文字数:参照文字起こしの(空白を除いた)文字数
[
\text{CER} = \frac{\text{Character edit distance}}{\text{Total characters}}
]
Real‑Time Factor (RTF)
処理スループットは Real‑Time Factor で評価します:
[
\text{RTF} = \frac{\text{Processing Time}}{\text{Audio Duration}}
]
ここで Processing Time は
other.yaml に記録された processtime-at と completed-at の差分、Audio Duration は同ファイルの audio-duration から取得しています。実装メモ
- すべての指標は、参照と仮説のアラインメント結果に基づいています。
- 単語レベル・文字レベルの編集距離はいずれも、高速な Levenshtein 実装で計算しています。
- アラインメントエンジンは C++ 最適化されたバックエンドで動作します。
- 系列長を (n)、(m) とすると、時間計算量は概ね O(nm) です。
result.json内の値はすべて決定的かつ再現可能であり、同じ入力からは必ず同じ出力が得られます。
4. モデル概要 (Model Overview)
本ベンチマークで評価したモデル構成は 1 つだけです:
- Whisper BASE(saytowords-mode: base)
中程度の容量を持つ汎用 Speech‑to‑Text モデルで、英語の多様なアクセントや長尺音声への対応を想定しています。このテストでは、追加のファインチューニングや人手修正を行わず、そのままの状態で利用し、実際のインタビューに対する「生の挙動」を観察しました。
将来的には、より小型または大型の Whisper バリアントや、Whisper 以外のモデル群との比較も可能ですが、本記事ではこの 1 つのベースラインにフォーカスします。
5. 結果サマリー(result.json より) (Results)
以下の値は
test-transcripts/bill-interview/result.json からそのまま取得したものです:- 音声長(秒):
653.2934375 - 処理時間(秒):
85.476 - 参照単語数(N):
1846 - 置換(S):
67 - 削除(D):
178 - 挿入(I):
23 - WER:
0.14517876489707476 - Accuracy:
0.8548212351029252 - 参照文字数:
7335 - 文字編集距離:
825 - CER:
0.11247443762781185 - RTF:
0.13083860191079907
読みやすく丸めると:
- WER ≈ 14.52%
- Accuracy ≈ 85.48%
- CER ≈ 11.25%
- RTF ≈ 0.13(約 7.6 倍速でリアルタイムより速い処理)
6. エラーパターン分析 (Error Pattern Analysis)
今回の評価には、タイムスタンプ単位の詳細な可視化やエラーラベルは付与されていないため、以下の分析は集計値のみに基づきます。
-
支配的なエラー種別:削除(deletions)
- 削除:
D = 178 - 置換:
S = 67 - 挿入:
I = 23
単語レベルのエラーの多くを削除が占めています。これは、モデルが内容を「盛る」よりも、単語を落としがちであることを示しています。インタビュー文脈では、機能語の抜け、速い発話の語尾落ち、複数話者の被り部分が丸ごと消える、といった形で現れやすくなります。
- 削除:
-
置換は存在するが、主役ではない
S = 67で、全エラーの約 1/4 程度を占めます。典型的には、音の似た単語の取り違え、固有名詞の誤認、モデルがあまり見慣れていない専門用語などが想定されます。 -
挿入エラーは比較的少ない
挿入はI = 23回のみ観測されています。これは、モデルが過剰な幻覚を起こしにくい(無い内容を勝手に作りにくい)性質を持つことと整合的で、足りない方向に振れやすいモデルだと解釈できます。
文字レベルでは:
- 文字編集距離 = 825、参照文字数 = 7335 から CER ≈ 11.25%。
約 14.5% の WER と比べて低い CER は、多くの誤単語が文字列としてはかなり近い(語尾変化の違い、軽微なスペルミス、結合・分割の違う複合語など)ことを示しています。
タイムスタンプ単位のエラー位置が無い以上、「インタビューのどの瞬間に失敗したか」をピンポイントで指摘することはできませんが、S/D/I の内訳だけでも有用なプロファイルが得られます:このシステムは過少転記(under‑transcribe)しやすいが、存在しない文を積極的にでっち上げる傾向は小さいと言えます。
7. 主なインサイト (Key Insights)
数値だけから見ても、いくつか明確なポイントが見えてきます:
-
インタビュー用途における速度と精度のバランスは悪くない
RTF ≈ 0.13 で、約 10.9 分 の音声を 約 1.4 分 で処理しつつ、WER ≈ 14.5% / CER ≈ 11.3% を維持しています。大量のインタビューをまとめて処理する用途には、十分「現実的な」動作点です。 -
エラー分布は削除に大きく偏っている
削除(178)が置換(67)や挿入(23)よりもはるかに多く、実運用では「少し足りない文字起こし」になりやすいことを意味します。誤った情報を勝手に生成するよりも、若干抜け落ちるリスクを取る挙動と言えます。 -
文字レベルの安定性は単語レベルより高い
CER が WER より低いことは、多くの誤単語が文字列としては参照に近いことを示します。語形やスペルにある程度のゆらぎを許容できる検索・トピッククラスタリング用途にとっては、悪くない特性です。 -
評価に用いた音声量は「おもちゃレベル」ではない
1846 語、7335 文字 という規模は、いくつかの例文ではなく、数分以上続く自然なインタビューに近いボリュームです。ここでの指標は、数分間の自発話にわたる平均的な振る舞いを反映しています。
8. このシナリオにおける「ベストモデル」 (Best Model for This Scenario)
今回のベンチマークでは Whisper BASE(base モード) のみを評価しています。そのため、これは同時に:
- この「表」における最も強いモデルであり、
- 唯一の比較対象でもあります。
その前提で、得られた挙動は次のとおりです:
- 約 11 分のインタビュー音声に対して WER ≈ 14.5%、Accuracy ≈ 85.5%。
- RTF ≈ 0.13、すなわち実時間の 7〜8 倍の速度で推論可能。
コンテンツのざっくり把握、検索、ラフな引用といった目的でインタビューを大量に文字起こししたい場合、この構成は数値的に見て十分実用的です。一方で、「1 語も間違えたくない」ような用途に対しては、現状の指標が示すとおり、依然として人手によるチェックや、より強力なモデルが必要になります。
9. 中立的な最終評価 (Neutral Final Verdict)
2026年2月26日に収録されたこの英語インタビューに対し、「base」モードの Whisper BASE は次のように振る舞いました:
- 挿入が少なく、削除が優勢なエラープロファイル、
- おもちゃではない参照トランスクリプトに対して 10 数 % 台前半の WER と 10 数 % 台前半の CER、
- 約 0.13 の Real‑Time Factor による、大規模バッチ処理向きのスループット。
数値的には一貫性があり再現性も高く、日々のベンチマーク用途には十分な速さです。第三者の評価者の視点からまとめると、この構成は英語インタビュー文字起こしの実用的なベースラインではあるものの、高度にセンシティブな領域で人間のレビューを完全に置き換える段階には、まだ到達していません。
参考アーティファクト (Reference Artifacts)
以下に、参照トランスクリプトとモデル出力トランスクリプトを埋め込むための折りたたみセクションを用意してあります。必要に応じて、VTT ファイルの全文を貼り付けて利用できます。
ref.vtt(参照トランスクリプト)
<!-- ここに test-transcripts/bill-interview/ref.vtt の全文を貼り付けてください -->
model.vtt(モデル出力トランスクリプト)
<!-- ここに test-transcripts/bill-interview/model.vtt の全文を貼り付けてください -->
