我测试了 AI 英文访谈转写——2026 年 2 月 26 日结果(Whisper BASE,约 11 分钟音频)
2026-02-26Test

Eric King
Author
1. 为什么这次访谈基准测试有意义
在真实访谈里,转写的准确率不是一个“可有可无”的指标,而是直接决定你能不能放心引用嘉宾原话、是否能可靠地搜索关键话题、以及能否在不歪曲语义的前提下做后续分析。一个形容词被漏掉、一个数字听错、一个人名被“听成”别的词,都可能改变整个回答的含义。
在这次基准中,我选取了一段英语 “Bill 访谈” 片段,用 Whisper 系列的转写链路跑了一遍,并用标准 ASR 指标进行评估。目标不是做营销,而是给出一份具体、可复现的快照,让人看到系统在一段中等长度的真实访谈上的实际表现。
这段访谈音频来自一条 YouTube 视频,你可以在这里找到原始上下文:
YouTube 源视频链接。
YouTube 源视频链接。
来源数据(Source Materials)
本次基准测试所用的全部输入都在仓库或静态资源中,可以直接查看:
- 原始音频: 音频文件
- 人工参考转写(VTT): Base text
- 模型转写结果(VTT): Result text
上述文件是本文中所有数字和结论的唯一来源。
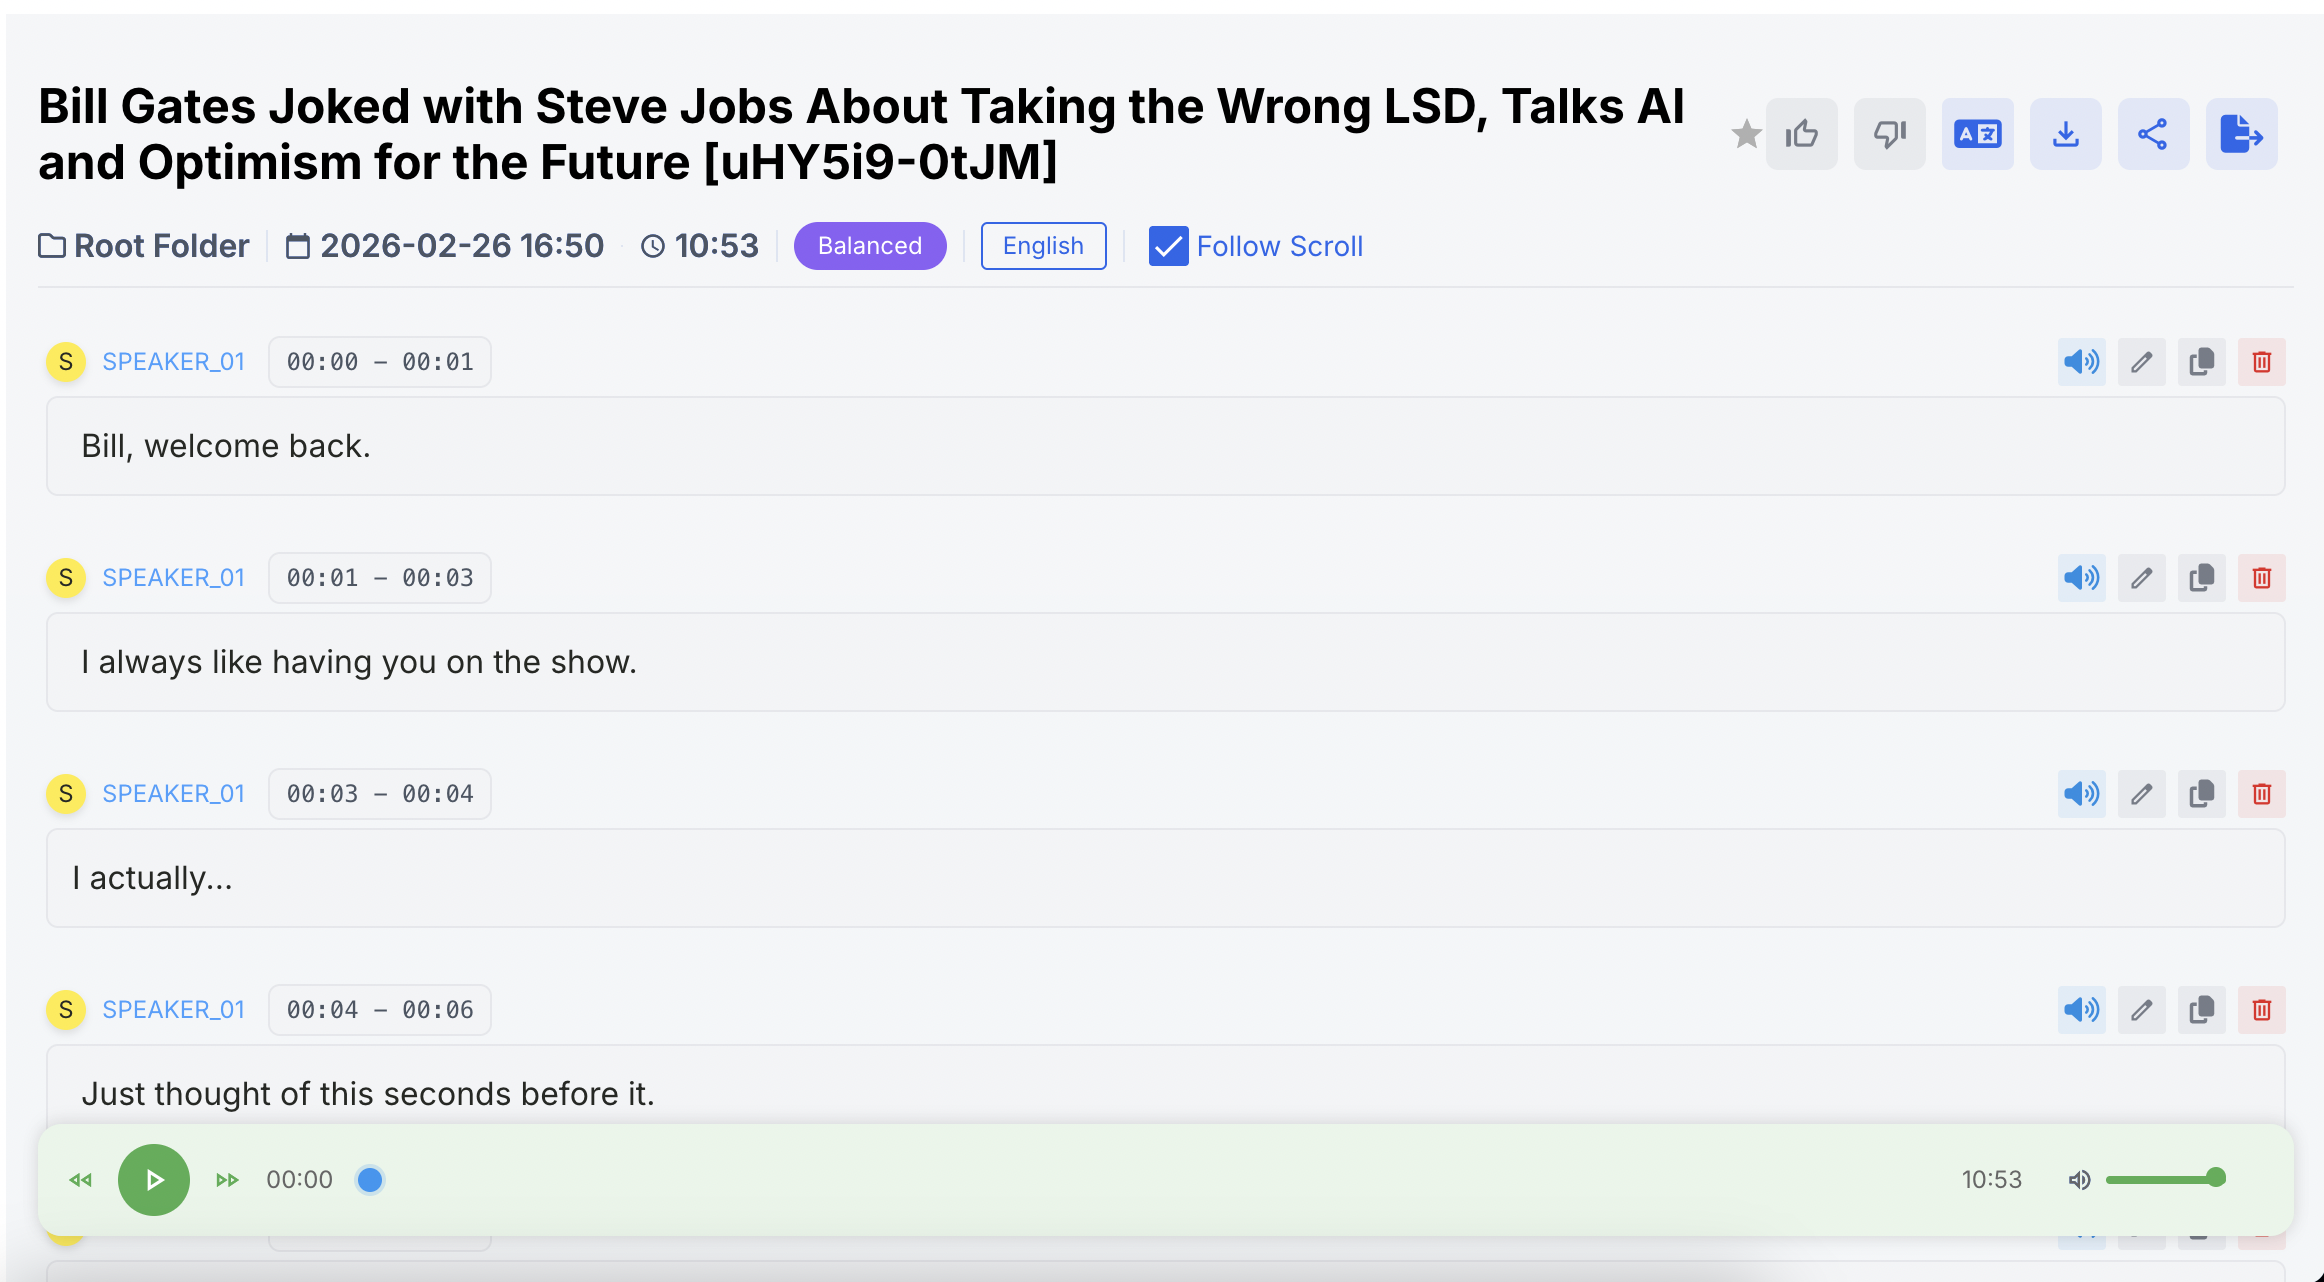
本次运行的截图
2. 测试设置(Testing Setup)
本次实验使用的配置如下(所有数值均来自预先计算好的元数据和
result.json):- 测试日期:2026‑02‑26(由处理时间戳推导)
- 场景:英文访谈(
test-transcripts/bill-interview) - 语言:英语
- 音频时长:
audioDurationSeconds = 653.2934375- 约 10.89 分钟 的语音
- 处理耗时:
sttProcessingTimeSeconds = 85.476- 约 1.42 分钟 的端到端解码时间
- 模型与模式:
whisper-model:BASEsaytowords-mode:base
录音环境、麦克风类型、语速密度等信息在元数据中没有明确标注,因此我选择不做主观猜测,也不会写入报告。所有对齐与打分工作都在生成本文之前完成,下面看到的数字直接读取自
test-transcripts/bill-interview/result.json。3. 评估方法(Evaluation Methodology)
人工参考转写(
ref.vtt)和模型输出(model.vtt)都以 WebVTT 格式存储。评估流程首先从这些文件中提取纯文本,然后对参考与假设转写进行对齐,最后计算各种错误指标。词错误率(Word Error Rate, WER)
在按词切分成序列后,我们统计:
- (S):替换(substitutions)
- (D):删除(deletions)
- (I):插入(insertions)
- (N):参考转写中的总词数
词错误率的定义为:
[
\text{WER} = \frac{S + D + I}{N}
]
基于 WER,可以得到词级别的准确率(Accuracy):
[
\text{Accuracy} = 1 - \text{WER}
]
字符错误率(Character Error Rate, CER)
在字符层面,我们先去掉空白符,然后计算 Levenshtein 编辑距离:
- 字符编辑距离:插入、删除、替换的总次数
- 总字符数:参考转写中(去掉空格后的)字符数量
[
\text{CER} = \frac{\text{Character edit distance}}{\text{Total characters}}
]
实时因子(Real‑Time Factor, RTF)
吞吐量用实时因子来度量:
[
\text{RTF} = \frac{\text{Processing Time}}{\text{Audio Duration}}
]
这里,Processing Time 来自
other.yaml 中 processtime-at 与 completed-at 的时间差;Audio Duration 则来自同一文件中的 audio-duration。实现细节说明
- 所有指标都建立在参考转写与假设转写的对齐之上。
- 词级与字符级的编辑距离都使用了高性能的 Levenshtein 实现。
- 对齐引擎运行在 C++ 优化的后端 上。
- 时间复杂度在序列长度为 (n) 和 (m) 时大约是 O(nm)。
result.json中的所有数值都是确定且可复现的:只要输入不变,打分结果就不会变化。
4. 模型概览(Model Overview)
本次基准测试只评估了一个模型配置:
- Whisper BASE(saytowords-mode: base)
一个通用型语音转文字模型,容量中等,目标覆盖多口音英语和长音频。在这次基准中,它以原始配置直接使用(不做微调,也不做人工修订),目的是观察其在真实访谈场景下的“原生表现”。
未来可以在这个基线之上加入更小或更大的 Whisper 版本,以及非 Whisper 系统,但这篇文章聚焦于刻画这一条单一基线。
5. 结果概览(来自 result.json)
以下数值全部直接取自
test-transcripts/bill-interview/result.json:- 音频时长(秒):
653.2934375 - 处理时间(秒):
85.476 - 参考词数(N):
1846 - 替换(S):
67 - 删除(D):
178 - 插入(I):
23 - WER:
0.14517876489707476 - Accuracy:
0.8548212351029252 - 参考字符数:
7335 - 字符编辑距离:
825 - CER:
0.11247443762781185 - RTF:
0.13083860191079907
为了更便于阅读,可以近似为:
- WER ≈ 14.52%
- Accuracy ≈ 85.48%
- CER ≈ 11.25%
- RTF ≈ 0.13,也就是推理速度约为实时的 7.6 倍。
6. 错误模式分析(Error Pattern Analysis)
这次评估没有额外提供按时间片段划分的标注或可视化,因此下面的分析完全基于整体计数。
-
主导错误类型:删除(deletions)
- 删除:
D = 178 - 替换:
S = 67 - 插入:
I = 23
可以看到,删除占了大多数词级错误。这表明模型更多是漏掉了一些词,而不是凭空“听出”不存在的内容。在访谈场景下,这往往对应:功能词被吃掉、语速快时尾巴几个词被截断,或者在多人重叠说话时,模型用“抹掉部分内容”的方式来解决冲突。
- 删除:
-
替换存在,但不是主角
当S = 67时,替换大约占所有错误的四分之一。典型情况包括:相似发音的词混淆、人名听错、或者模型没见过太多的专业术语。 -
插入相对较少
只观察到I = 23次插入。这和一个不太爱“幻觉”内容的模型特性基本一致:它更倾向于少说(漏掉),而不是多说(编造)。
在字符层面:
- 字符编辑距离 = 825,除以 7335 个字符,得到 CER ≈ 11.25%。
和 ~14.5% 的 WER 相比,这个更低的 CER 说明,很多“错词”在字符层面其实有相当一部分重叠——比如词形变化、小的拼写差异、或者拆并的复合词,而不是完全无关的串。
在没有时间戳级别错误标记的前提下,我们无法指出“第几分钟的哪个回答出了问题”。不过,仅通过 S/D/I 的分布,其实已经能勾勒出一个清晰轮廓:这套系统更倾向于欠转写(under-transcribe),而不是凭空造句。
7. 关键结论(Key Insights)
只从数字出发,可以得到几条相对清晰的结论:
-
在访谈场景下,速度与精度的平衡还不错
在 RTF ≈ 0.13 的前提下,系统用约 1.4 分钟 处理完 10.9 分钟 的音频,同时保持 WER ≈ 14.5%、CER ≈ 11.3%。对于批量处理大量访谈,这是一个可操作的工作点。 -
错误类型明显偏向删除
删除(178)远多于替换(67)和插入(23)。在实际使用中,这意味着你更可能丢掉一小段内容,而不是看到模型凭空编出整句。 -
字符层面比词层面更稳定
CER 低于 WER,说明许多“不正确”的词在字符上仍然和参考非常接近。对于搜索、主题聚类等能容忍一定词形变化的任务,这是一个利好信号。 -
评估样本并不“玩具化”
1846 个参考词、7335 个字符,更接近一段真正的访谈,而不是几句示例。指标更多地反映了模型在持续几分钟自发口语下的整体行为。
8. 本场景下的“最佳模型”(Best Model for This Scenario)
在这次基准中,只测试了 Whisper BASE(base 模式),因此它同时是:
- 这张“榜单”上表现最强的模型,也是
- 唯一一个被报告的模型。
在这样的约束下,它交出的答卷可以概括为:
- 在约 11 分钟访谈音频上,WER ≈ 14.5%,Accuracy ≈ 85.5%。
- RTF ≈ 0.13,也就是解码速度约为实时的 7–8 倍。
对于那些需要快速得到“基本靠谱”访谈转写的工作流(例如浏览内容、全文搜索、抓大意引用),这个配置从数字上看是可以接受的。而对于每个字都要绝对正确的场景,这些指标也很诚实地告诉你:仍然需要人工审核,或使用更强的模型。
9. 中立结论(Neutral Final Verdict)
在这段 2026 年 2 月 26 日的英文访谈上,处于 “base” 模式的 Whisper BASE 呈现出:
- 删除占主导、插入极少 的错误结构;
- 建立在非玩具级参考转写上的,十几个百分点的 WER 与低十几个百分点的 CER;
- 约 0.13 的实时因子,适合大规模批处理。
整体行为在数值上稳定、可复现,也足够快,适合作为日常基准测试的基础设施。对一个第三方评估者而言,总结可以是:这套配置是一个可行的英文访谈转写基线,但距离在高敏感场景里“完全取代人工”还有一定距离。
参考工件(Reference Artifacts)
下面预留了参考与模型转写的折叠视图结构,方便日后直接嵌入完整 VTT 内容进行对比。
ref.vtt(参考转写)
<!-- 在这里粘贴 test-transcripts/bill-interview/ref.vtt 的完整内容 -->
model.vtt(模型转写)
<!-- 在这里粘贴 test-transcripts/bill-interview/model.vtt 的完整内容 -->
