Come funziona la conversione voce-testo e cosa influenza la precisione
2025-11-27Documentazione

Eric King
Author
Introduzione
La conversione voce-testo (STT), o riconoscimento automatico del parlato (ASR), trasforma il linguaggio parlato in testo scritto. I sistemi di IA moderni sono molto accurati, ma la qualità della trascrizione dipende da molteplici fattori lungo l’intero flusso. L’articolo illustra come funziona lo STT e gli elementi chiave che ne influenzano l’efficacia.
La conversione voce-testo (STT), o riconoscimento automatico del parlato (ASR), trasforma il linguaggio parlato in testo scritto. I sistemi di IA moderni sono molto accurati, ma la qualità della trascrizione dipende da molteplici fattori lungo l’intero flusso. L’articolo illustra come funziona lo STT e gli elementi chiave che ne influenzano l’efficacia.
Il flusso STT
Il processo STT si articola in più fasi:
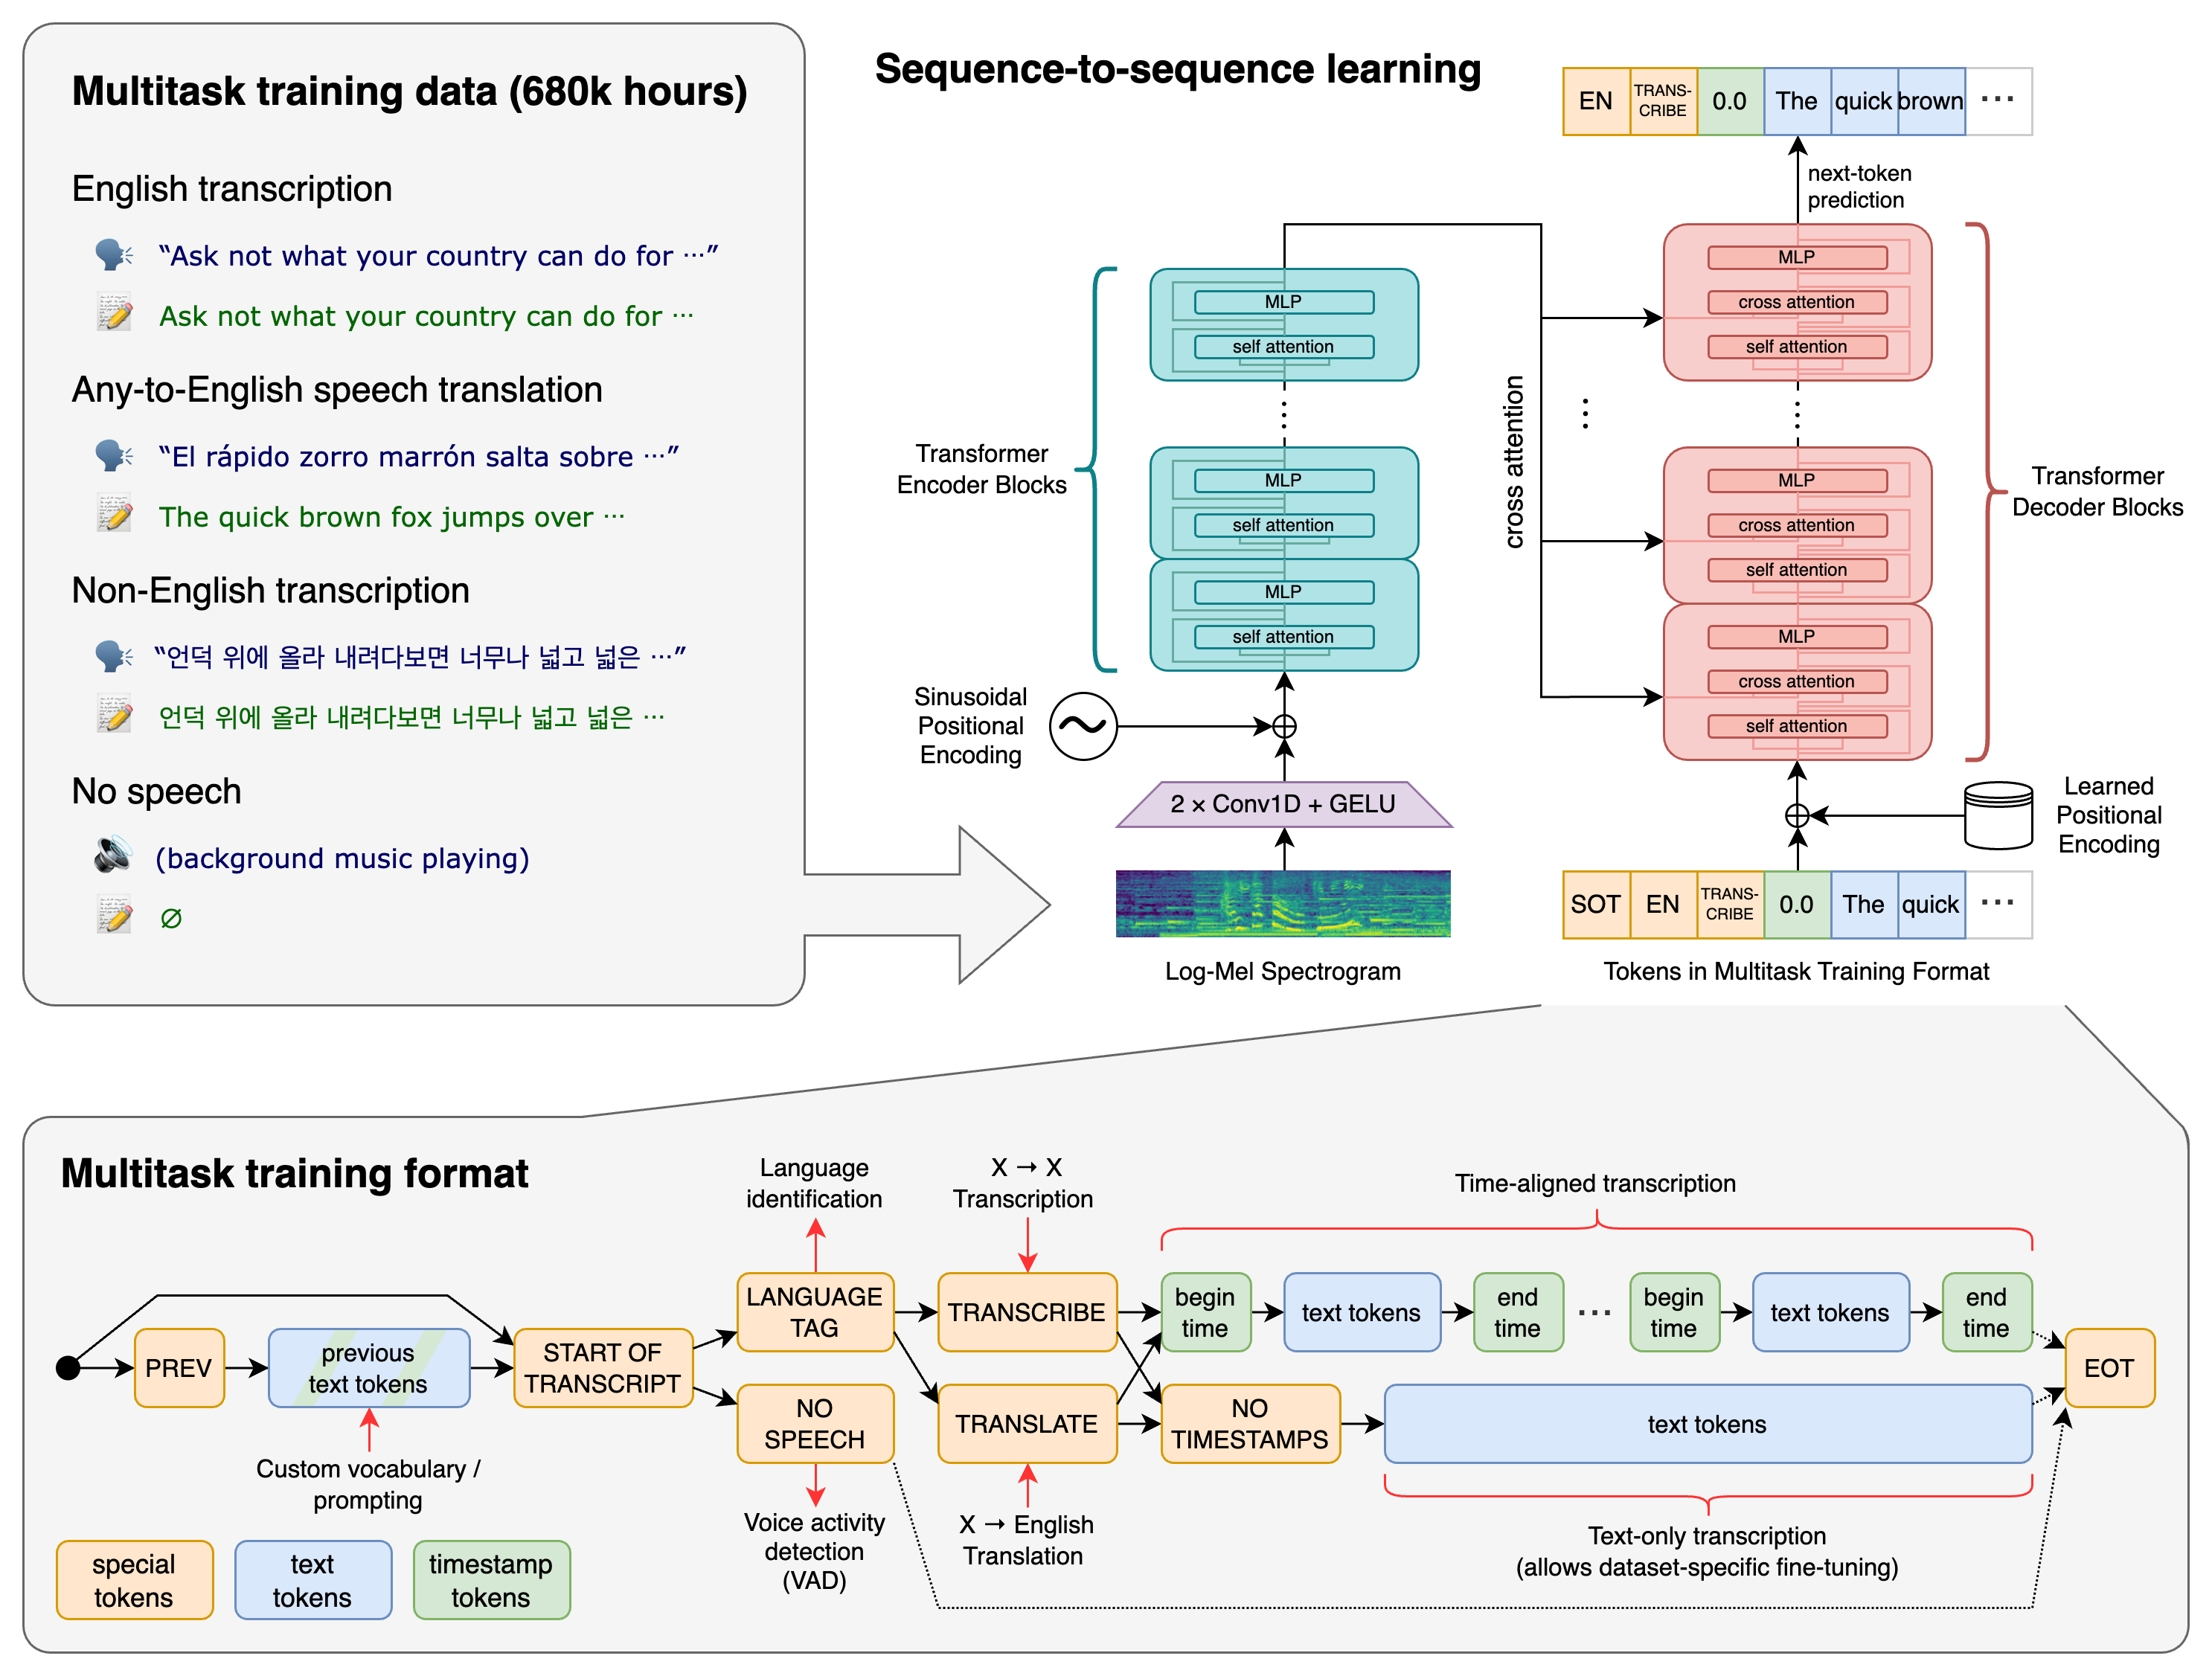
Ingresso audio → Pre-elaborazione → Estrazione di feature → Modello acustico → Modello del linguaggio → Decodifica → Post-elaborazione → Output testuale
Ogni fase è importante per la qualità della trascrizione.
1. Ingresso audio
- Fonte: Microfoni, registrazioni caricate o streaming live.
- Fattori di qualità: Audio chiaro con poco rumore di fondo migliora il riconoscimento.
- Frequenza di campionamento e formato: Frequenze più alte (es. 16–48 kHz) preservano i dettagli del parlato e aiutano l’estrazione delle feature.
Impatto sull’accuratezza: Dispositivi di registrazione scadenti o file di bassa qualità riduono la fedeltà del suono e causano errori nelle fasi successive.
2. Pre-elaborazione
- Riduzione del rumore: Elimina il rumore di fondo che può confondere il modello.
- Normalizzazione: Mantiene livelli di volume coerenti nell’intera registrazione.
- Segmentazione (framing): Suddivide l’audio in finestre brevi (di solito 20–40 ms) per l’elaborazione sequenziale.
Impatto sull’accuratezza: Una pre-elaborazione insufficiente lascia che rumore, riverbero o volume irregolare distorca il segnale e abbassi la qualità del riconoscimento.
3. Estrazione di feature
- Converte le finestre audio in rappresentazioni numeriche (feature) per il modello.
- Feature comuni:
- MFCC (Mel-Frequency Cepstral Coefficients): Catturano componenti frequenziali importanti.
- Spettrogrammi: Mostrano la distribuzione dell’energia nel tempo e in frequenza.
- Feature opzionali: altezza tonale, energia o coefficienti delta.
Impatto sull’accuratezza: Se le feature non rappresentano bene il parlato, il modello acustico può fraintendere i fonemi, soprattutto con parlato veloce o accentato.
4. Modello acustico
- Associa le feature a fonemi o caratteri.
- Modelli moderni:
- RNN/LSTM/GRU: Catturano sequenze temporali.
- CNN: Rilevano pattern frequenziali locali.
- Transformer: Modellano contesto a lungo raggio nel parlato.
Impatto sull’accuratezza: Dimensione del modello, diversità dei dati di addestramento e robustezza al rumore determinano quanto bene vengono riconosciute pronunce e accenti.
5. Modello del linguaggio
- Predice sequenze di parole in base a contesto, grammatica e vocabolario.
- Aiuta con gli omofoni e risolve fonemi ambigui.
Impatto sull’accuratezza: Modelli del linguaggio deboli o limitati possono produrre frasi grammaticalmente errate o prive di senso anche se i fonemi sono corretti.
6. Decodifica
- Integra le uscite del modello acustico e del modello del linguaggio per generare il testo finale.
- Tecniche:
- CTC (Connectionist Temporal Classification): Allinea finestre audio e testo predetto.
- Beam search: Sceglie sequenze di parole più probabili.
Impatto sull’accuratezza: Una decodifica errata può disallineare audio e testo, in particolare con parlato veloce o voci sovrapposte.
7. Post-elaborazione
- Aggiunge punteggiatura, maiuscole e formattazione (numeri, date, valute).
- Correzioni opzionali di dominio migliorano leggibilità e accuratezza.
Impatto sull’accuratezza: Senza post-elaborazione il testo può risultare poco strutturato o ambiguo anche se il riconoscimento a livello di fonema è corretto.
Fattori chiave delle prestazioni STT
- Qualità audio: Registrazioni chiare e fedeli sono fondamentali.
- Rumore di fondo: Musica, folla o rumore ambientale riduono l’accuratezza.
- Variabilità del parlante: Accento, velocità e intonazione influenzano il riconoscimento.
- Vocabolario e dominio: Termini tecnici, slang o parole rare possono essere fraintesi.
- Addestramento del modello: Modelli addestrati su dataset diversificati sono più robusti ad accenti e rumore.
- Segmentazione e silenzi: Separare bene parlato, silenzio e più parlanti migliora la chiarezza della trascrizione.
In sintesi, l’accuratezza dello STT non dipende da un singolo componente, ma dall’interazione tra qualità audio, pre-elaborazione, estrazione di feature, modellazione e post-elaborazione.
Conclusione
L’IA voce-testo è una pipeline a più stadi che trasforma l’audio in testo. Capire il flusso aiuta a capire perché compaiono errori e come ottimizzare le prestazioni. Concentrandosi su audio di alta qualità, pre-elaborazione efficace, modellazione robusta e post-elaborazione accurata, sviluppatori e utenti ottengono trascrizioni più precise e affidabili.
Spunto chiave: L’efficacia dello STT dipende sia dalla pipeline tecnica sia dalla qualità dell’input; anche i modelli più avanzati richiedono audio pulito e ben strutturato per prestazioni ottimali.