Whisper を理解する:OpenAI の音声認識モデル完全ガイド

はじめに
OpenAI の Whisper は、話し言葉の音声を正確で読みやすいテキストに変換するための高度な自動音声認識(ASR)モデルです。オープンソースとして公開されて以来、多言語対応、ノイズ耐性、実運用での柔軟性により、最も広く使われる文字起こし技術のひとつになりました。
本記事では、Whisper の仕組み、独自性、長所と限界、そして業界の主要 ASR モデルとの比較について、SEO を意識した分かりやすい概要をまとめます。
Whisper とは?
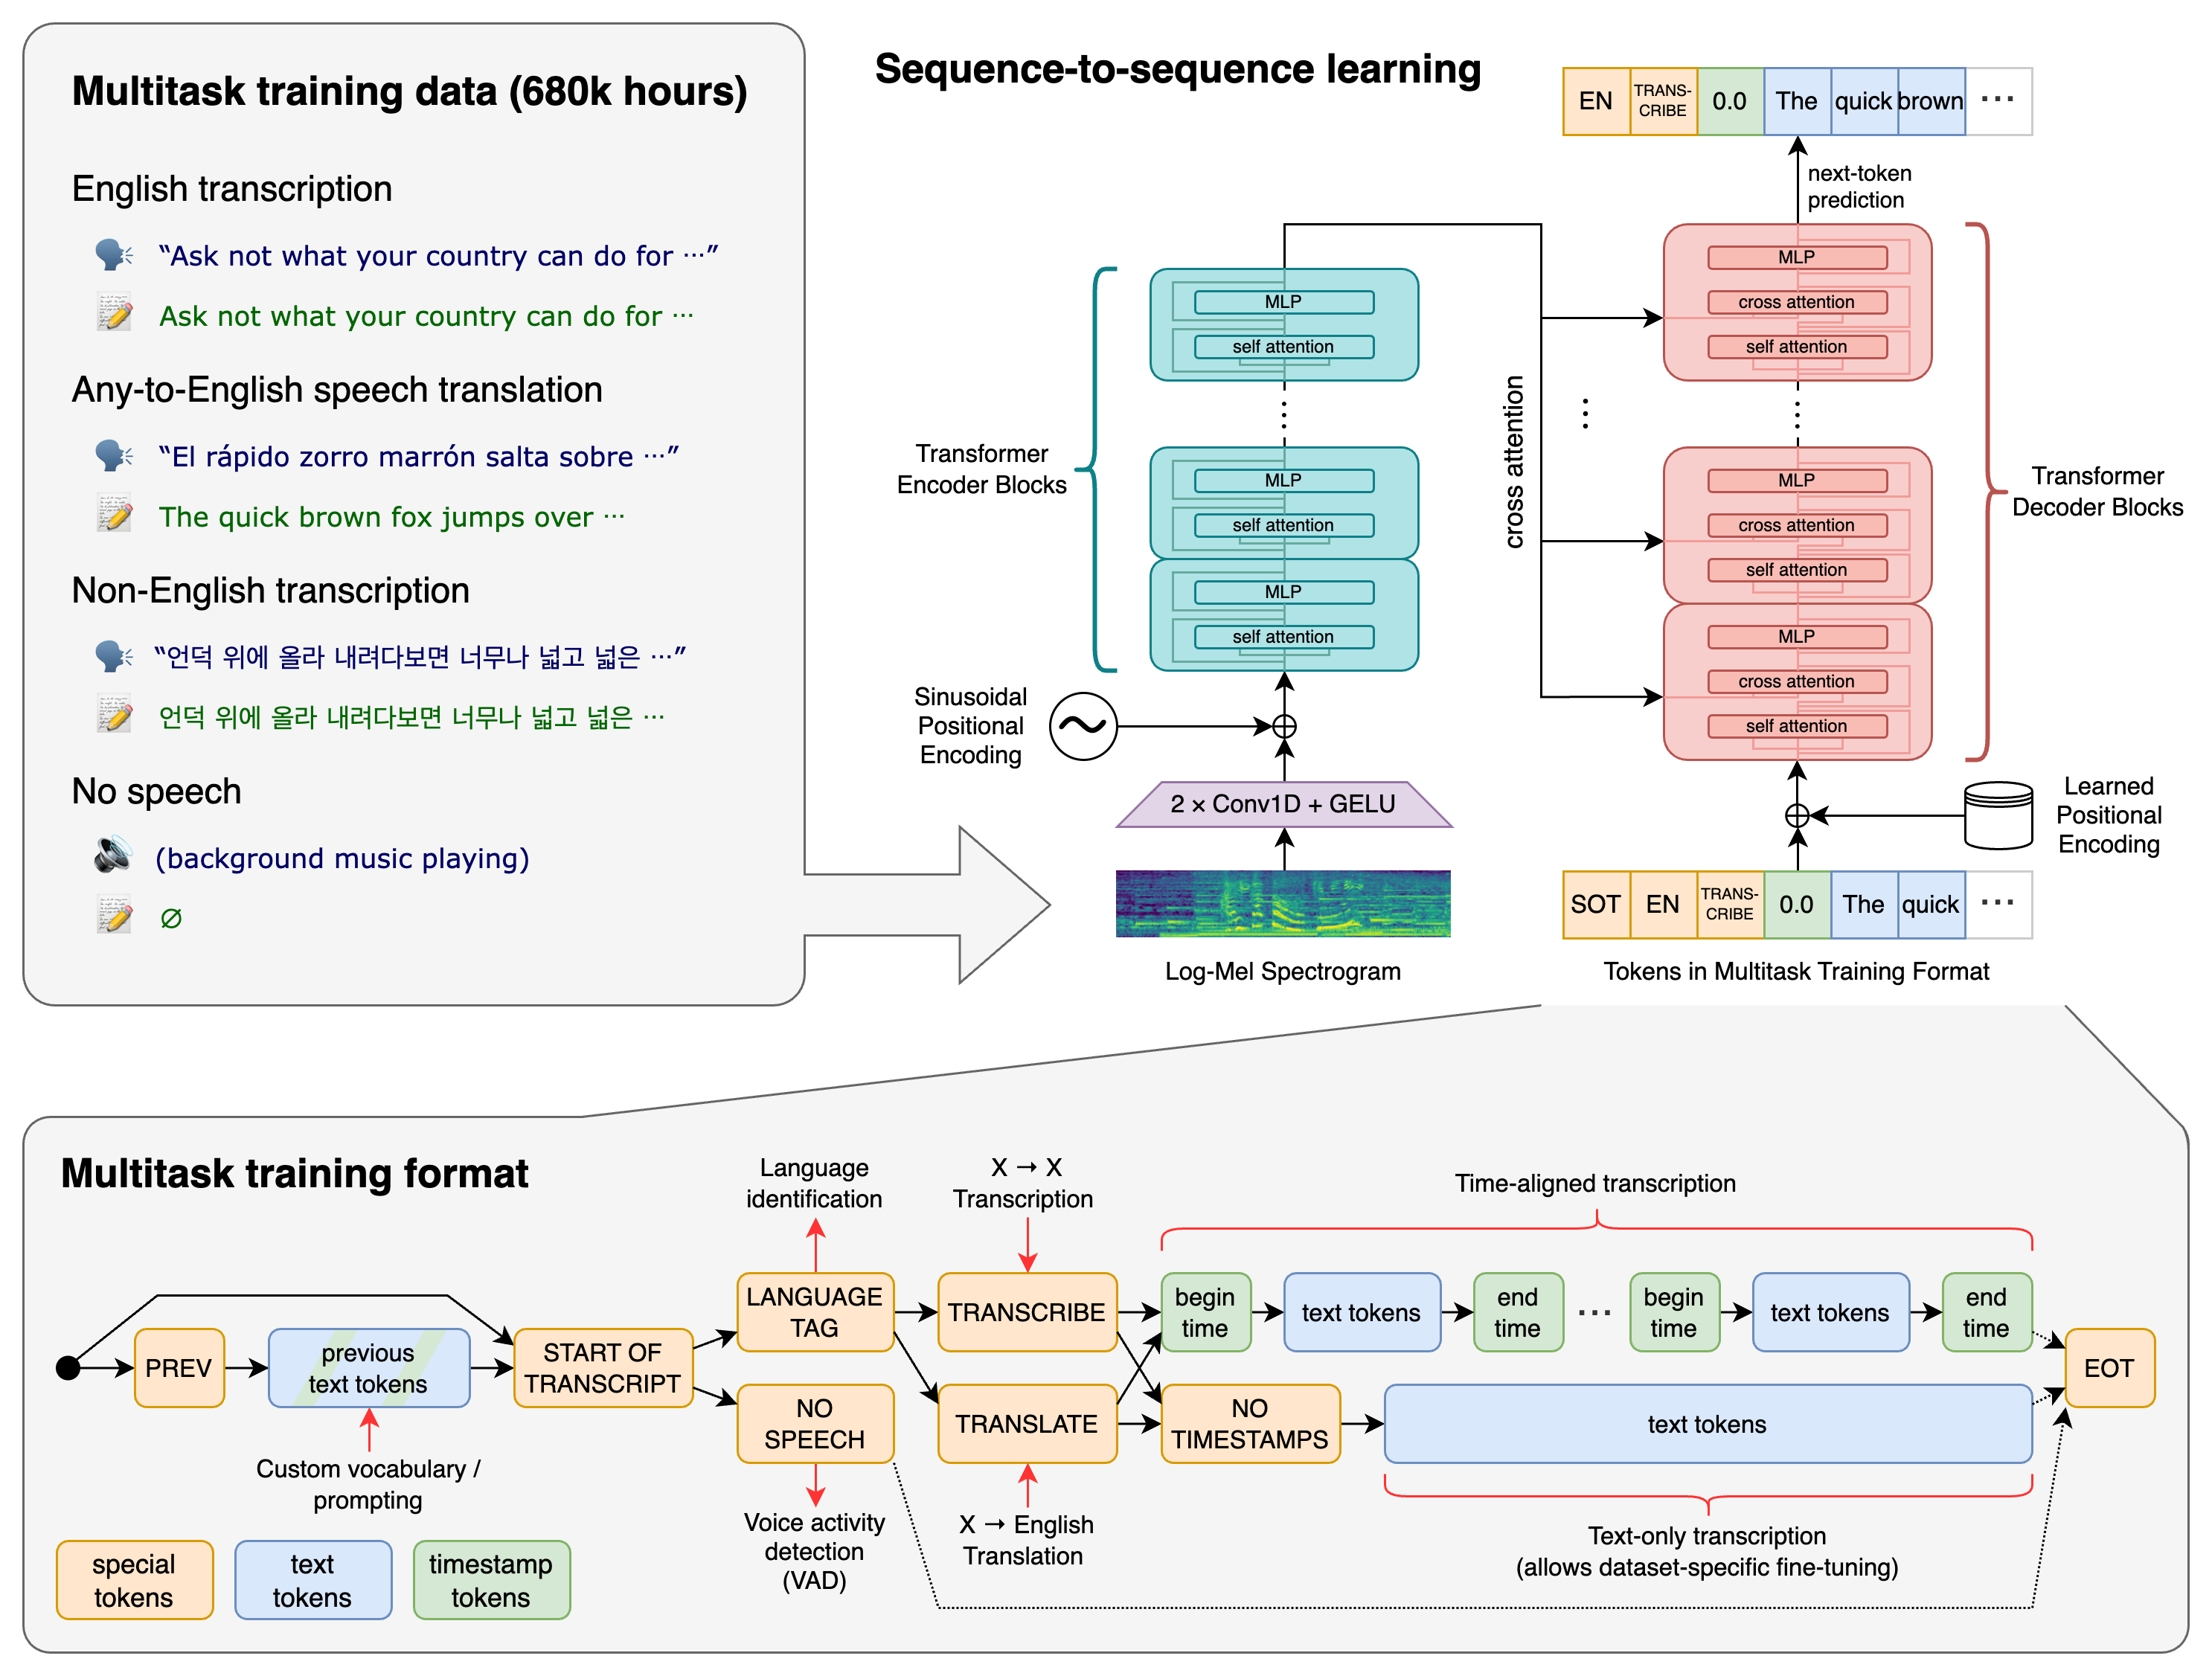
Whisper は、ウェブ上から収集した約 68 万時間分の多言語・マルチタスク教師ありデータで学習したディープラーニング ASR です。多様なアクセント、雑音環境、音質が学習に含まれるため、従来型の音声認識モデルよりはるかにロバストです。
Whisper が扱える主なタスク
- 音声からテキストへの文字起こし
- 音声翻訳(音声 → 英語テキスト)
- 言語識別
- タイムスタンプ生成
- 多言語文字起こし
オープンソースのため、開発者はローカル実行、ワークフローの調整、アプリへの組み込みを、サードパーティ API に依存せず行えます。
Whisper の主な特徴
1. 多言語音声認識
約 100 言語に近い規模をサポートし、グローバル向けアプリや多様なユーザー層に適しています。
2. 高いノイズ耐性
大規模データの学習により、次のような条件にも対応します。
- 背景ノイズ
- 声の重なり
- 残響
- 品質の低いマイク
会議、インタビュー、モバイル録音など、実世界の音声に向いています。
3. 単語レベルのタイムスタンプ
Whisper(および WhisperX などの拡張)では、次の用途向けに正確なタイムスタンプを生成できます。
- 字幕
- ポッドキャストの区切り
- 動画のキャプション制作フロー
4. 翻訳機能
英語以外の音声を、別途の翻訳モデルなしに英語テキストへ直接変換できます。
5. 完全オープンソース
次のような環境に展開できます。
- オンプレミスサーバー
- クラウド VM
- GPU 付きローカル PC
- エッジデバイス
オープンソースであることで、コスト・プライバシー・カスタマイズを自分でコントロールできます。
Whisper のモデルサイズ
| サイズ | 速度 | 精度 | 用途 |
|---|---|---|---|
| Tiny | 最速 | 最低 | リアルタイム、モバイル |
| Base | 非常に速い | 低〜中 | 素早い文字起こし |
| Small | バランス | 中 | 一般的なタスク |
| Medium | やや遅い | 高 | プロ用途の文字起こし |
| Large | 最も遅い | 最高 | 最高精度・多言語 |
選び方は、計算資源と精度要件によります。
Whisper の長所
- 難しい条件下でも高い認識精度
- 多くの商用 ASR よりアクセント・方言に強い
- 多言語を標準サポート
- オープンソース(ベンダーロックインなし、改造可能)
- タイムスタンプとセグメンテーション
Whisper の限界
- 高速化には GPU リソースがそれなりに必要
- 大規模モデルは CPU では遅くなりがち
- ノイズの多い音声では、短い非音声テキストの幻覚が出ることがある
- 言語ごとの句読点ルールなど、構造化された音声タスクには最適化されていない
Faster-Whisper、WhisperX、GPU 上の量子化など、最適化されたフォークで緩和されることが多いです。
Whisper と他の ASR モデル(競合比較)
Whisper と代表的な ASR を並べた、SEO を意識した比較です。
ASR 比較表
| 項目 / モデル | OpenAI Whisper | Google Speech-to-Text | Amazon Transcribe | Microsoft Azure STT | Deepgram |
|---|---|---|---|---|---|
| オープンソース | はい | いいえ | いいえ | いいえ | 一部(SDK のみ) |
| 多言語 | 非常に良い | 良い | 中程度 | 良い | 中程度 |
| ノイズ耐性 | 非常に強い | 中程度 | 中程度 | 中程度 | 強い |
| タイムスタンプ | はい | はい | はい | はい | はい |
| リアルタイム | 限定的(ハード依存) | はい | はい | はい | はい |
| コスト | 無料(自前ホスト) | 有料 | 有料 | 有料 | 有料 |
| カスタマイズ | 完全(OSS) | 限定的 | 限定的 | 限定的 | 中程度 |
| 精度 | 高い | 高い | 高い | 高い | 高い |
まとめ
Whisper はオープンさ、コスト面、ノイズ耐性で際立ちます。クラウド ASR は低遅延のリアルタイムに強く、Whisper は柔軟性とプライバシーに優れます。
人気の Whisper 拡張
1. Faster-Whisper
CTranslate2 を使った最適化実装。メリット:
- 推論が約 2〜4 倍高速
- メモリ使用量削減
- int8 / int16 量子化に対応
本番サーバー向け。
2. WhisperX
Whisper を拡張し、次を追加:
- 単語レベルのアライメント
- より正確なタイムスタンプ
- 話者分離(Pyannote 経由)
字幕、ポッドキャスト、メディア向け文字起こしに適しています。
3. Distil-Whisper
蒸留により小型・高速化し、精度低下を最小限にした版。
どんなとき Whisper を使うべきか
次のようなニーズがある場合に Whisper は向いています。
- 高精度の文字起こし
- 多言語音声
- プライバシー重視の運用
- パイプラインの自由な設計
- 大規模でもコストを抑えた ASR
- オフライン/オンデバイス文字起こし
レイテンシが最優先なら、クラウド ASRの方が適することがあります。
結論
Whisper はオープンソース音声認識における重要な一歩です。性能、多言語対応、柔軟性により、文字起こしや翻訳アプリを作る開発者・研究者・企業にとって強力な選択肢になります。
WhisperX や Faster-Whisper などコミュニティの革新が続くなか、Whisper エコシステムは拡大しており、現代の ASR ワークフローにも適した選択です。
