Whisper 이해하기: OpenAI 음성 인식 모델 완전 가이드

서론
OpenAI의 Whisper는 말하는 오디오를 정확하고 읽기 쉬운 텍스트로 바꾸는 고급 자동 음성 인식(ASR) 모델입니다. 오픈 소스로 공개된 이후 다국어 지원, 노이즈에 대한 강건함, 실제 환경에서의 유연성 덕분에 가장 널리 쓰이는 전사 기술 중 하나가 되었습니다.
이 글에서는 Whisper의 동작 방식, 차별점, 장단점, 그리고 업계의 다른 주요 ASR 모델과의 비교를 SEO에 맞춰 정리합니다.
Whisper란?
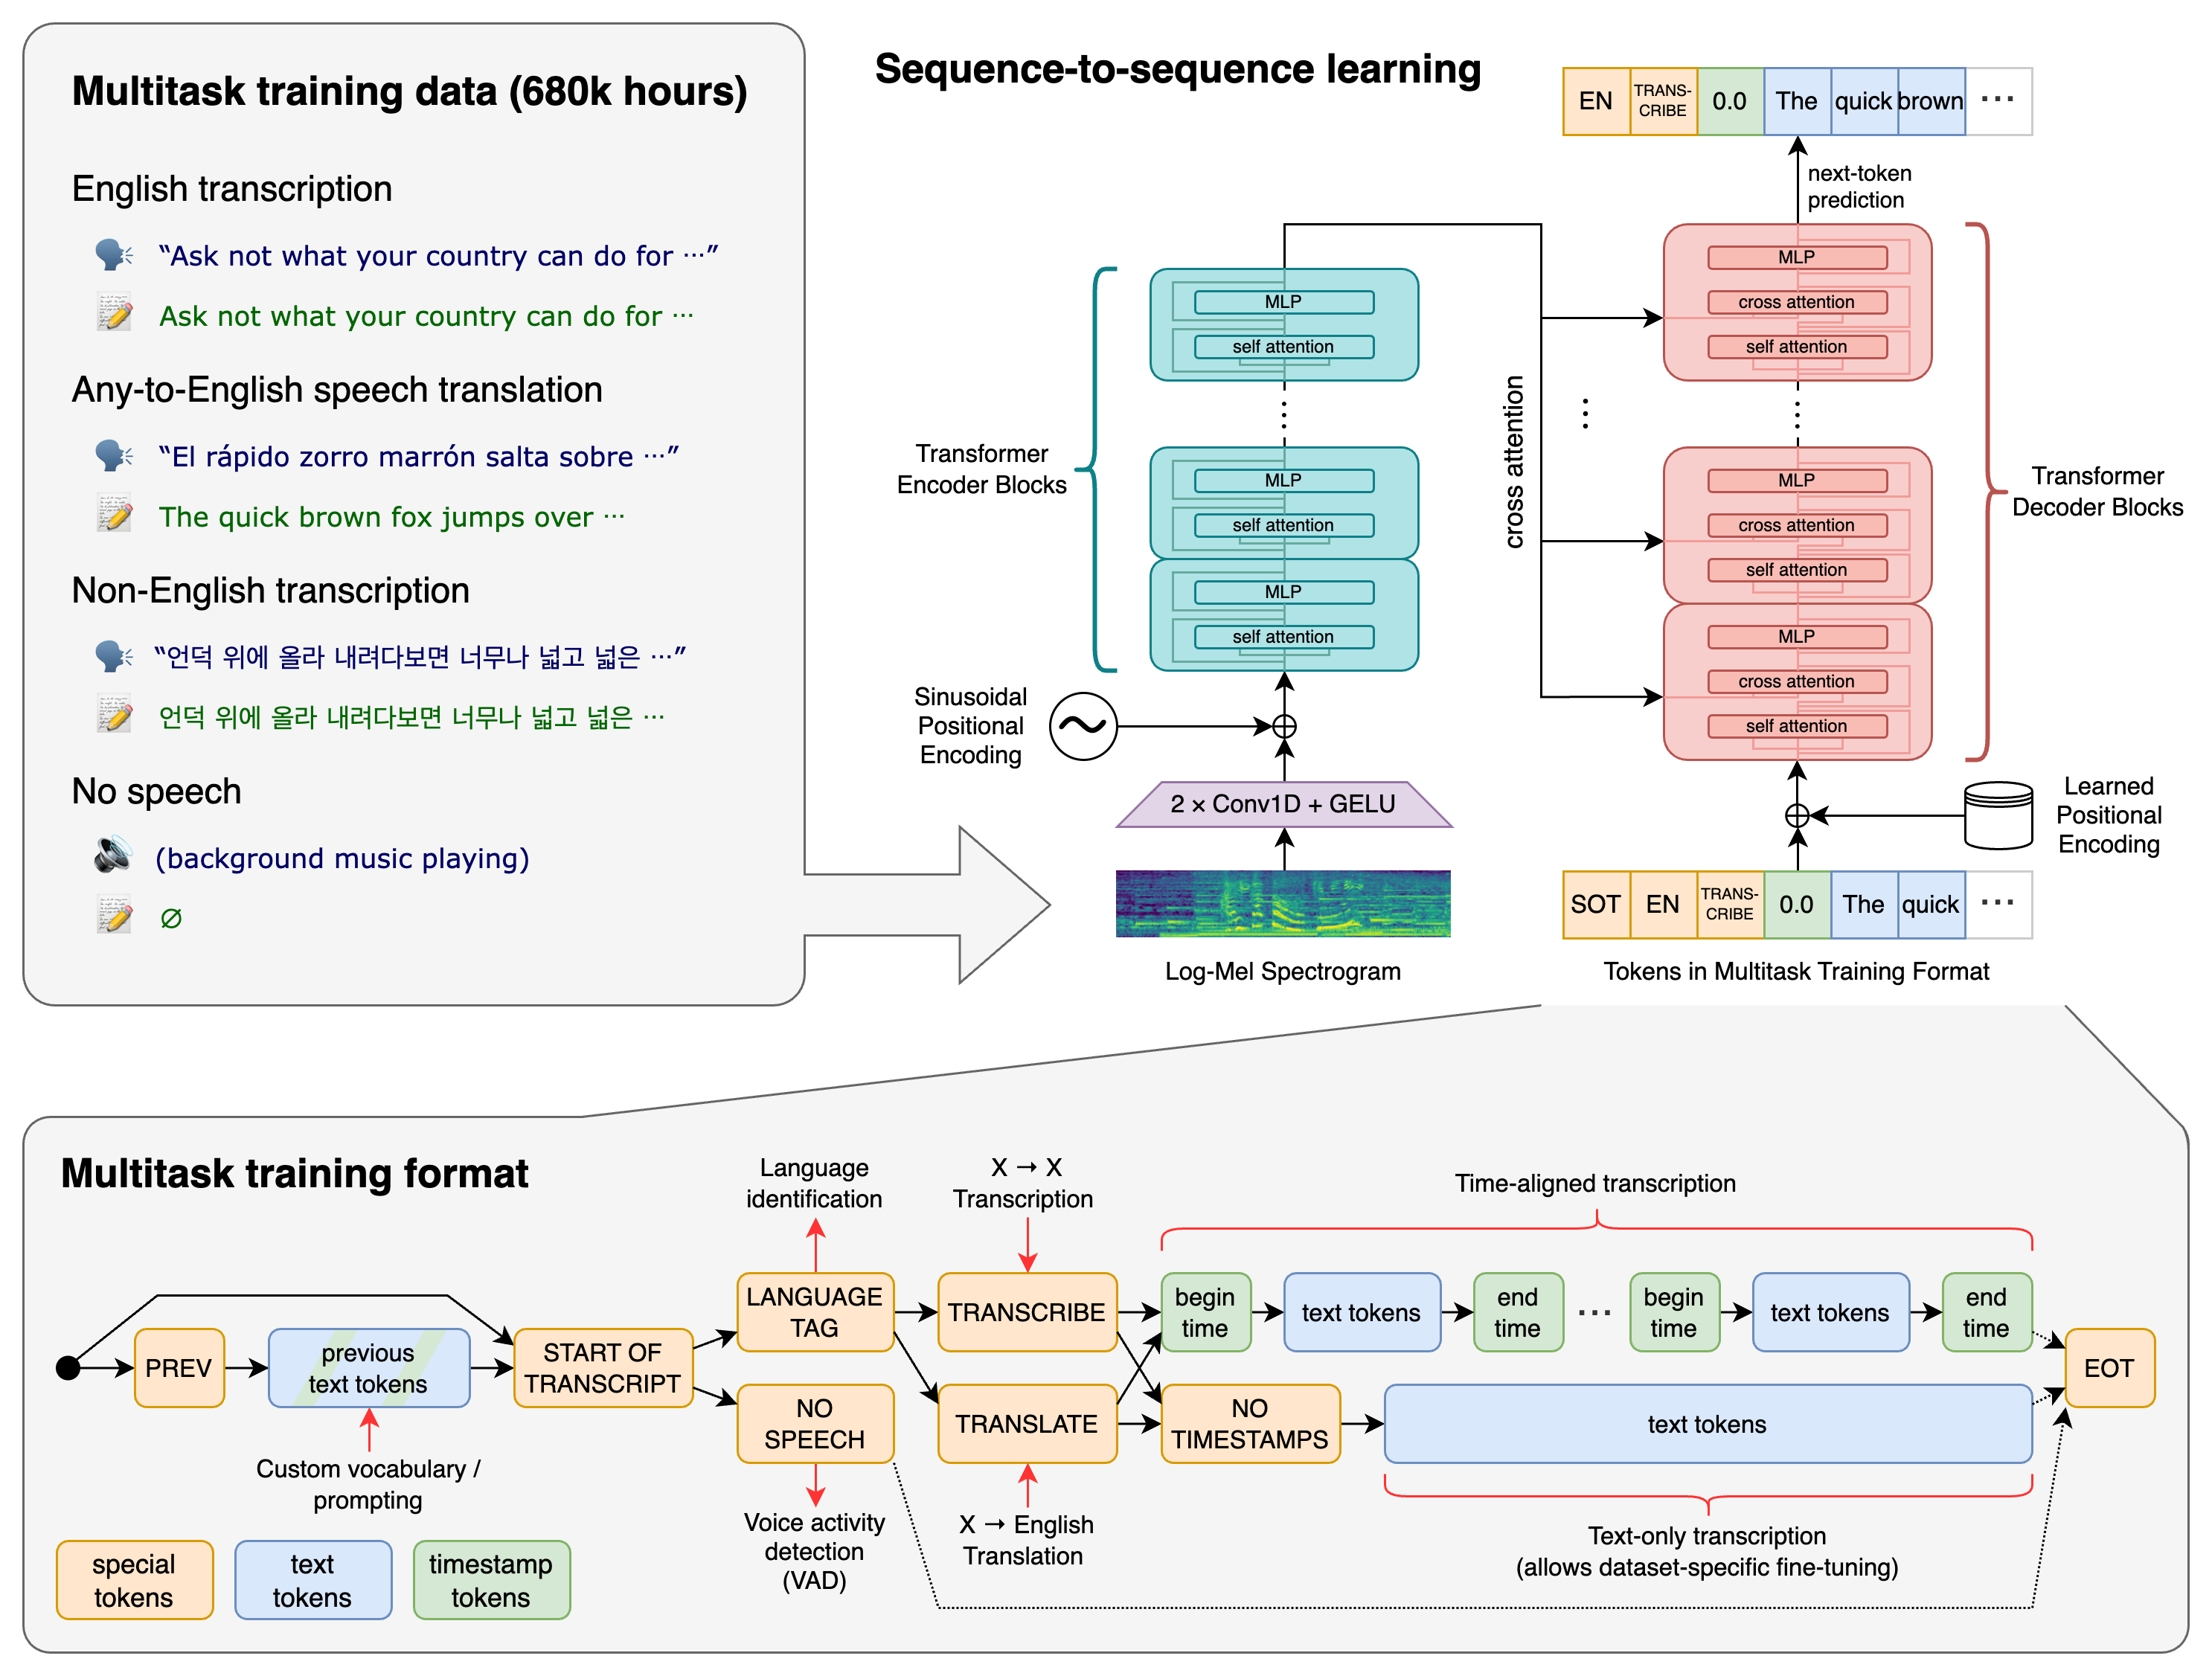
Whisper는 웹에서 수집한 다국어·다중 작업 지도 학습 데이터 약 68만 시간으로 학습한 딥러닝 ASR입니다. 다양한 억양, 잡음 조건, 음질이 포함되어 있어 기존 음성 인식 모델보다 훨씬 강건합니다.
Whisper가 지원하는 주요 작업
- 음성-텍스트 전사
- 음성 번역(오디오 → 영어 텍스트)
- 언어 식별
- 타임스탬프 생성
- 다국어 전사
오픈 소스이므로 개발자는 로컬에서 실행하고, 워크플로를 조정하거나, 서드파티 API 없이 앱에 통합할 수 있습니다.
Whisper의 주요 기능
1. 다국어 음성 인식
거의 100개 언어에 가까운 지원으로 글로벌 서비스와 다양한 사용자층에 적합합니다.
2. 높은 노이즈 강건성
대규모 학습 데이터 덕분에 다음을 처리합니다.
- 배경 소음
- 겹치는 발화
- 잔향
- 품질이 낮은 마이크
회의, 인터뷰, 모바일 녹음 같은 실제 오디오에 맞습니다.
3. 단어 수준 타임스탬프
Whisper(및 WhisperX 등 확장)는 다음을 위해 정확한 타임스탬프를 만들 수 있습니다.
- 자막
- 팟캐스트 구간 나누기
- 동영상 자막 워크플로
4. 번역 기능
별도 번역 모델 없이 비영어 오디오를 영어 텍스트로 직접 옮길 수 있습니다.
5. 완전 오픈 소스
다음 환경에 배포할 수 있습니다.
- 온프레미스 서버
- 클라우드 VM
- GPU가 있는 로컬 데스크톱
- 엣지 기기
오픈 소스이므로 비용, 프라이버시, 맞춤 설정을 직접 제어할 수 있습니다.
Whisper 모델 변형
| 모델 크기 | 속도 | 정확도 | 용도 |
|---|---|---|---|
| Tiny | 가장 빠름 | 가장 낮음 | 실시간, 모바일 |
| Base | 매우 빠름 | 낮음~중간 | 빠른 전사 |
| Small | 균형 | 중간 | 일반 작업 |
| Medium | 느림 | 높음 | 전문 전사 |
| Large | 가장 느림 | 최고 | 최고 정확도, 다국어 |
선택은 보통 연산 자원과 정확도 요구에 따라 결정합니다.
Whisper의 장점
- 까다로운 환경에서도 높은 정확도
- 많은 상용 ASR보다 억양·방언 처리에 유리
- 다국어를 기본 지원
- 오픈 소스(벤더 종속 없음, 커스터마이징 가능)
- 타임스탬프와 구간 분할
Whisper의 한계
- 빠른 속도를 위해 상당한 GPU 자원이 필요할 수 있음
- 대형 모델은 CPU에서 느릴 수 있음
- 잡음이 심한 오디오에서 짧은 비음성 텍스트가 환각으로 나올 수 있음
- 언어별 구두점 규칙 등 구조화된 음성 작업에는 최적화되어 있지 않음
Faster-Whisper, WhisperX, GPU 양자화 같은 최적화 포크로 완화하는 경우가 많습니다.
Whisper vs 다른 ASR 모델
Whisper와 잘 알려진 ASR 시스템을 비교한 표입니다.
ASR 비교 표
| 기능 / 모델 | OpenAI Whisper | Google Speech-to-Text | Amazon Transcribe | Microsoft Azure STT | Deepgram |
|---|---|---|---|---|---|
| 오픈 소스 | 예 | 아니오 | 아니오 | 아니오 | 부분(SDK만) |
| 다국어 | 매우 우수 | 좋음 | 보통 | 좋음 | 보통 |
| 노이즈 강건성 | 매우 강함 | 보통 | 보통 | 보통 | 강함 |
| 타임스탬프 | 예 | 예 | 예 | 예 | 예 |
| 실시간 | 제한적(하드웨어 의존) | 예 | 예 | 예 | 예 |
| 비용 | 무료(자체 호스팅) | 유료 | 유료 | 유료 | 유료 |
| 맞춤화 | 전체(OSS) | 제한적 | 제한적 | 제한적 | 보통 |
| 정확도 | 높음 | 높음 | 높음 | 높음 | 높음 |
요약
Whisper는 개방성, 비용 이점, 노이즈 강건성에서 두드러집니다. 클라우드 ASR은 저지연 실시간에 강하고, Whisper는 유연성과 프라이버시에 유리합니다.
인기 Whisper 확장
1. Faster-Whisper
CTranslate2를 쓰는 최적화 구현. 이점:
- 추론 속도 2~4배
- 메모리 사용 감소
- int8/int16 양자화 지원
프로덕션 서버에 적합합니다.
2. WhisperX
Whisper에 다음을 더합니다.
- 단어 수준 정렬
- 더 정확한 타임스탬프
- 화자 분리(Pyannote)
자막, 팟캐스트, 미디어 전사에 적합합니다.
3. Distil-Whisper
증류로 더 작고 빠른 버전이며 정확도 손실은 최소입니다.
언제 Whisper를 쓸까?
다음이 필요할 때 Whisper가 잘 맞습니다.
- 고정확도 전사
- 다국어 오디오
- 프라이버시 중심 배포
- 맞춤 파이프라인
- 비용 효율적인 대규모 ASR
- 오프라인·온디바이스 전사
지연이 최우선이라면 클라우드 ASR이 여전히 나을 수 있습니다.
결론
Whisper는 오픈 소스 음성 인식에서 가장 중요한 진보 중 하나입니다. 강한 성능, 다국어, 유연성으로 전사·번역 앱을 만드는 개발자, 연구자, 기업에 강력한 도구입니다.
WhisperX, Faster-Whisper 같은 커뮤니티 혁신이 이어지며 Whisper 생태계는 계속 성장하고, 현대 ASR 워크플로에도 훌륭한 선택입니다.
